Jeong Hun Yeo

Postdoctoral Researcher · School of Electrical Engineering, KAIST

Multimodal AI for Human Communication

I am a postdoctoral researcher in the Integrated Vision & Language Lab at KAIST, supported by the Jang Young Sil Postdoctoral Fellowship. I received my Ph.D. in Electrical Engineering from KAIST in 2026, advised by Prof. Yong Man Ro.

My research builds multimodal AI for human communication — across languages, in real time, and over the course of a conversation. I work on visual and audio-visual speech recognition, diffusion language models for efficient decoding, and agents with memory and reasoning.
Jeong Hun Yeo

News

Aug 2026
Two papers accepted to EMNLP 2026.
Mar 2026
Started as a postdoctoral researcher at KAIST, supported by the Jang Young Sil Postdoctoral Fellowship.
Feb 2026
Received my Ph.D. in Electrical Engineering from KAIST.
Jan 2026
GCAgent accepted to IEEE TMM; a paper on multimodal emotion reasoning accepted to AAAI 2026.
Jun 2025
Zero-AVSR accepted to ICCV 2025. Gave an invited talk at ETRI.

Publications

* equal contribution. Also on Google Scholar.

2026

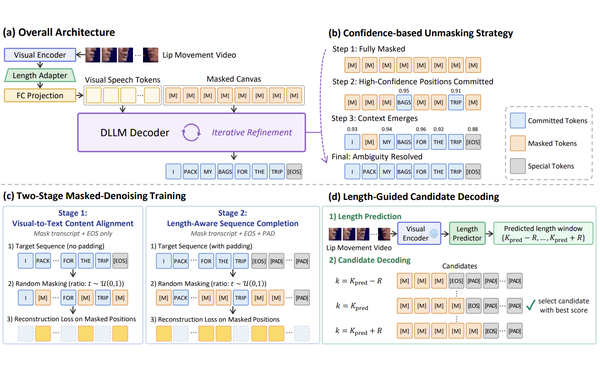
Diffusion Large Language Models for Visual Speech Recognition

Jeong Hun Yeo, Chae Won Kim, Hyeongseop Rha, Yong Man Ro

EMNLP 2026  ·  paper / code

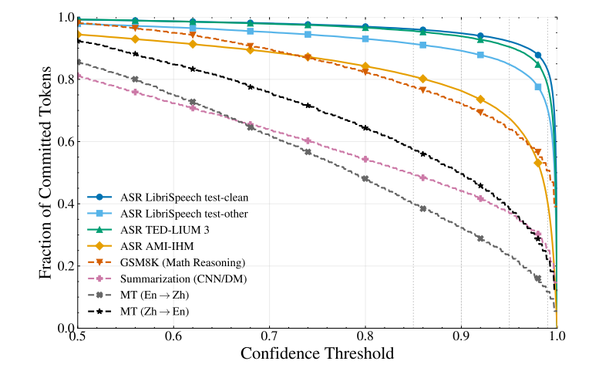
Decoding Strategies for Diffusion-Based ASR: A Systematic Evaluation of Confidence-Based Thresholding

Jeong Hun Yeo, Minsu Kim, Hyeongseop Rha, Yong Man Ro

EMNLP 2026  ·  paper

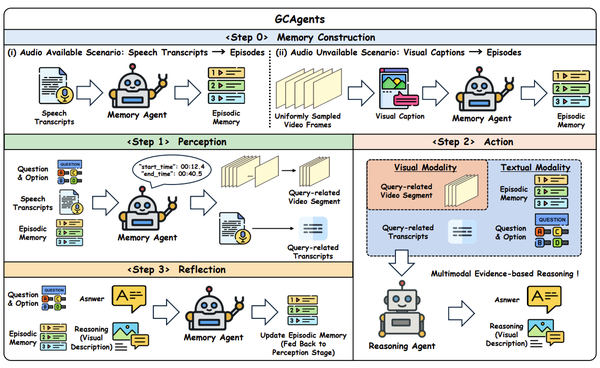
GCAgent: Long-Video Understanding via Schematic and Narrative Episodic Memory

Jeong Hun Yeo*, Sangyun Chung*, Sungjune Park, Dae Hoe Kim, Jinyoung Moon, Yong Man Ro

IEEE TMM 2026  ·  paper

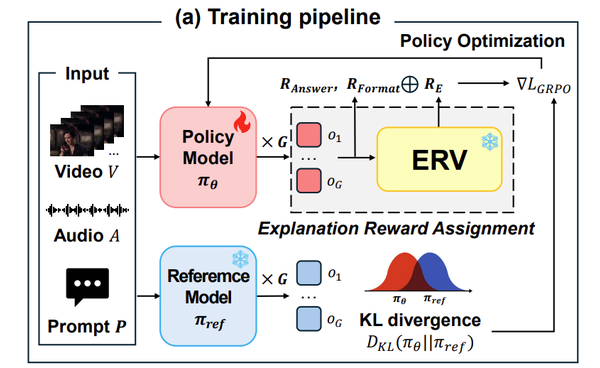
Emotion-Coherent Reasoning for Multimodal LLMs via Emotional Rationale Verifier

Hyeongseop Rha, Jeong Hun Yeo, Yeonju Kim, Yong Man Ro

AAAI 2026  ·  paper / code

2025

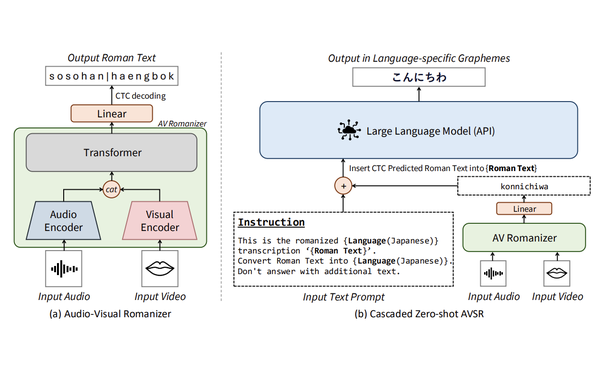
Zero-AVSR: Zero-Shot Audio-Visual Speech Recognition with LLMs by Learning Language-Agnostic Speech Representations

Jeong Hun Yeo*, Minsu Kim*, Chae Won Kim, Stavros Petridis, Yong Man Ro

ICCV 2025  ·  paper / code

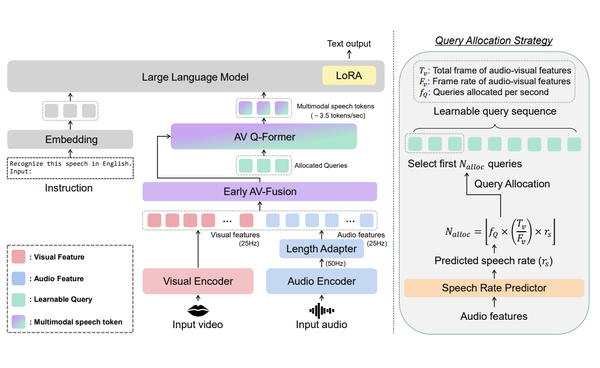
MMS-LLaMA: Efficient LLM-based Audio-Visual Speech Recognition with Minimal Multimodal Speech Tokens

Jeong Hun Yeo*, Hyeongseop Rha*, Se Jin Park, Yong Man Ro

Findings of ACL 2025  ·  paper / code

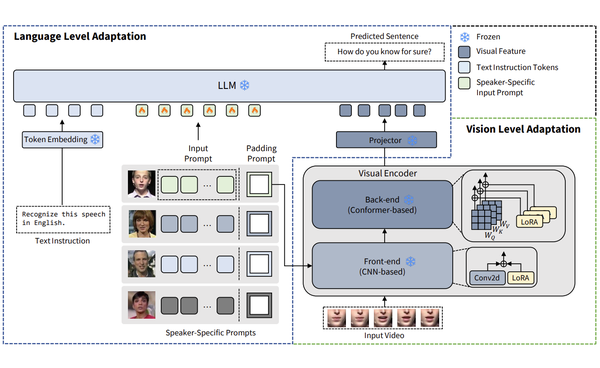
Personalized Lip Reading: Adapting to Your Unique Lip Movements with Vision and Language

Jeong Hun Yeo, Chae Won Kim, Hyunjun Kim, Hyeongseop Rha, Seunghee Han, Wen-Huang Cheng, Yong Man Ro

AAAI 2025  ·  paper / code

2024

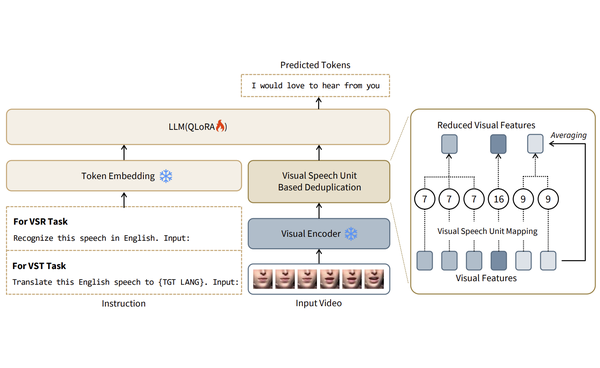
Where Visual Speech Meets Language: VSP-LLM Framework for Efficient and Context-Aware Visual Speech Processing

Jeong Hun Yeo*, Seunghee Han*, Minsu Kim, Yong Man Ro

Findings of EMNLP 2024  ·  paper / code

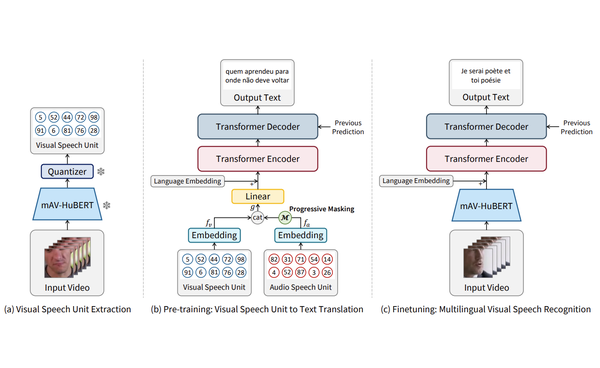
Efficient Training for Multilingual Visual Speech Recognition: Pre-training with Discretized Visual Speech Representation

Minsu Kim*, Jeong Hun Yeo*, Se Jin Park, Hyeongseop Rha, Yong Man Ro

ACM MM 2024  ·  paper / code

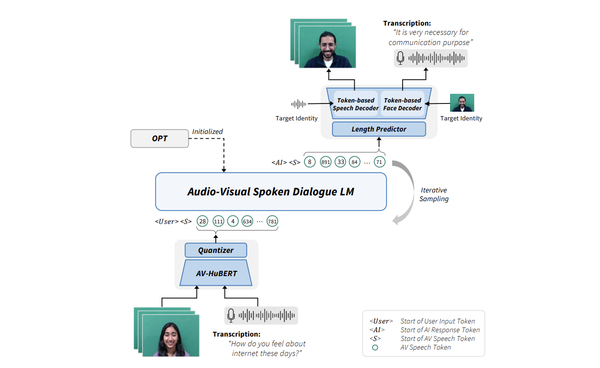
Let's Go Real Talk: Spoken Dialogue Model for Face-to-Face Conversation

Se Jin Park*, Chae Won Kim*, Hyeongseop Rha, Minsu Kim, Joanna Hong, Jeong Hun Yeo, Yong Man Ro

ACL 2024 (Oral)  ·  paper / data / demo

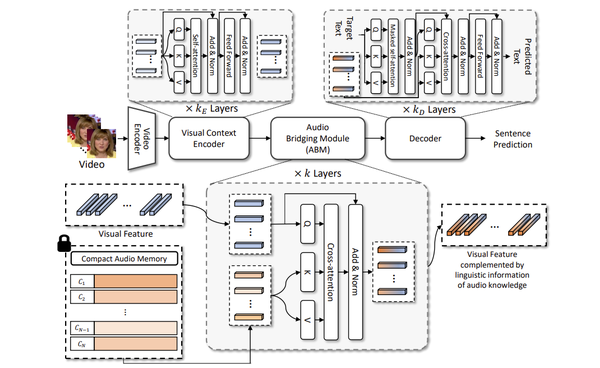
AKVSR: Audio Knowledge Empowered Visual Speech Recognition by Compressing Audio Knowledge of a Pretrained Model

Jeong Hun Yeo, Minsu Kim, Jeongsoo Choi, Dae Hoe Kim, Yong Man Ro

IEEE TMM 2024  ·  paper

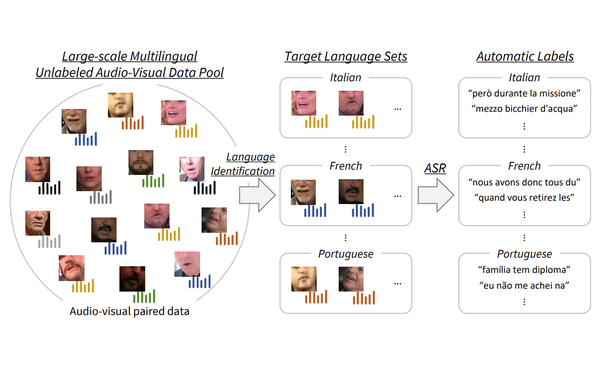
Visual Speech Recognition for Languages with Limited Labeled Data using Automatic Labels from Whisper

Jeong Hun Yeo*, Minsu Kim*, Shinji Watanabe, Yong Man Ro

ICASSP 2024 (Oral)  ·  paper / code

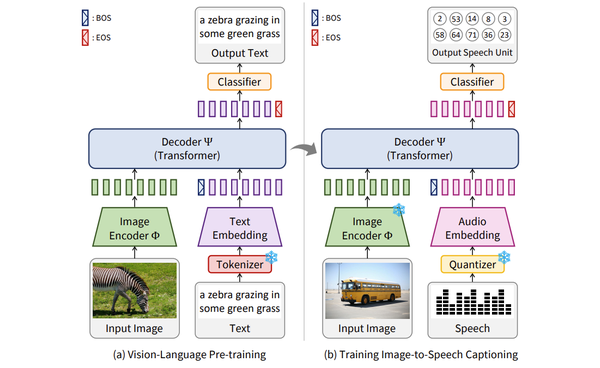
Towards Practical and Efficient Image-to-Speech Captioning with Vision-Language Pre-training and Multi-modal Tokens

Minsu Kim, Jeongsoo Choi, Soumi Maiti, Jeong Hun Yeo, Shinji Watanabe, Yong Man Ro

ICASSP 2024  ·  paper / code

2023

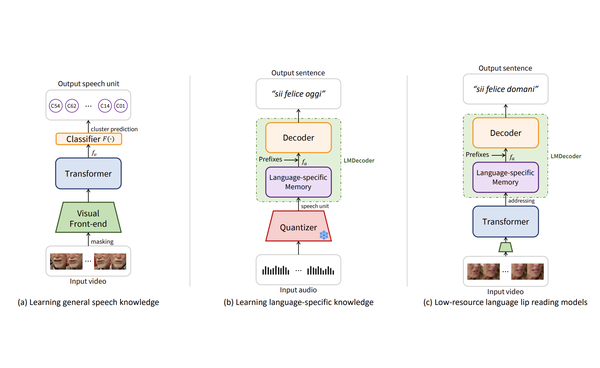
Lip Reading for Low-resource Languages by Learning and Combining General Speech Knowledge and Language-specific Knowledge

Minsu Kim*, Jeong Hun Yeo*, Jeongsoo Choi, Yong Man Ro

ICCV 2023  ·  paper / code

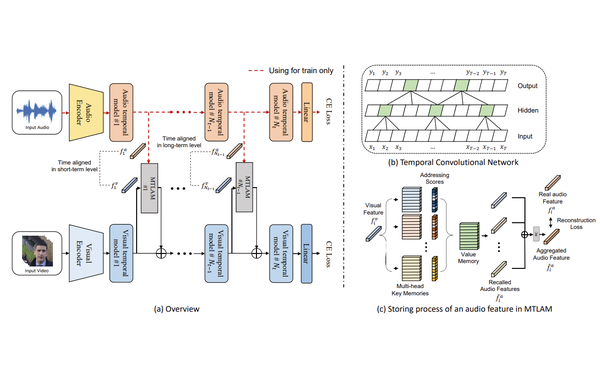
Multi-Temporal Lip-Audio Memory for Visual Speech Recognition

Jeong Hun Yeo, Minsu Kim, Yong Man Ro

ICASSP 2023  ·  paper

2022

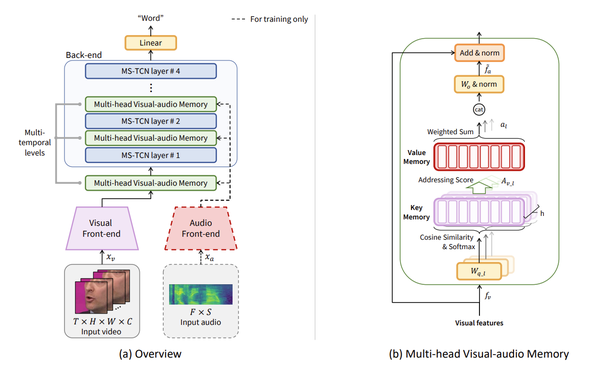
Distinguishing Homophenes Using Multi-head Visual-Audio Memory for Lip Reading

Minsu Kim, Jeong Hun Yeo, Yong Man Ro

AAAI 2022  ·  paper / code

Preprints

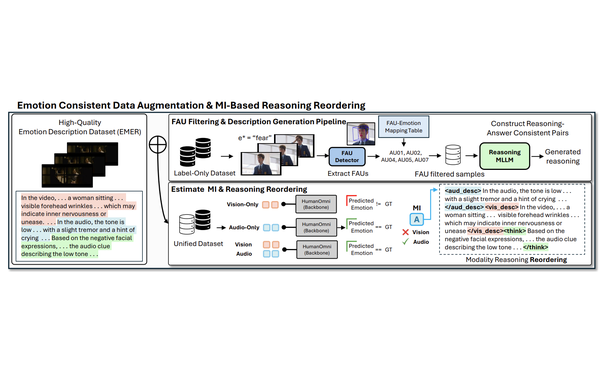
Learning What to Attend First: Modality-Importance-Guided Reasoning for Reliable Multimodal Emotion Understanding

Hyeongseop Rha*, Jeong Hun Yeo*, Se Jin Park, Yong Man Ro

arXiv 2025  ·  paper

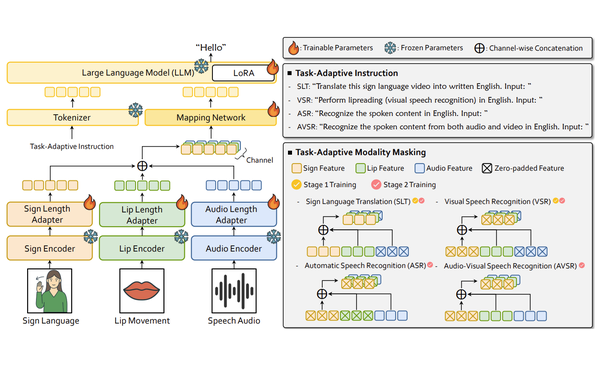
Towards Inclusive Communication: A Unified Framework for Generating Spoken Language from Sign, Lip, and Audio

Jeong Hun Yeo, Hyeongseop Rha, Sungjune Park, Junil Won, Yong Man Ro

arXiv 2025  ·  paper

Awards

Service

Journal reviewer IEEE TPAMI, IJCV, IEEE TIP, IEEE TMM, IEEE/ACM TASLP

Conference reviewer CVPR 2026, ICCV 2025, ECCV 2026, NeurIPS 2026, AAAI 2026, ARR 2025–2026, ICASSP 2025–2026, ICIP 2024–2025

Invited talk ETRI, “Efficient LLM-Based Audio-Visual Speech Recognition”, June 2025

Teaching Teaching assistant, Multimedia Processing and Learning, KAIST, Fall 2023